
Automatiser les contrôles qualité dans les projets d’annotation
Introduction
À mesure que les projets d’annotation gagnent en complexité, maintenir un niveau de qualité constant nécessite davantage que les processus de revue traditionnels.
De nombreux projets impliquent aujourd’hui plusieurs classes d’objets, des consignes d’annotation détaillées et des relations complexes entre les objets qui doivent être respectées. Garantir l’application cohérente de ces règles repose sur une combinaison d’expertise humaine et, lorsque cela est pertinent, de validations automatisées.
La revue qualité manuelle reste un élément fondamental de notre méthodologie d’annotation. Les reviewers apportent une expertise essentielle, notamment lorsqu’il s’agit de traiter des situations ambiguës ou des cas nécessitant une compréhension du contexte. Cependant, à mesure que les projets deviennent plus complexes et que les consignes se multiplient, vérifier manuellement chaque incohérence potentielle n’est plus une approche viable à grande échelle.
Dans cet article, nous explorons comment les contrôles qualité automatisés peuvent compléter les processus qualité existants lorsque les consignes d’un projet peuvent être traduites en règles de validation objectives. Nous verrons d’abord comment ces contrôles s’intègrent dans une stratégie qualité plus globale, puis nous présenterons deux approches complémentaires : les contrôles statistiques, qui permettent d’identifier des annotations atypiques et des anomalies potentielles, et les contrôles basés sur des règles, qui vérifient le respect des exigences définies pour le projet.
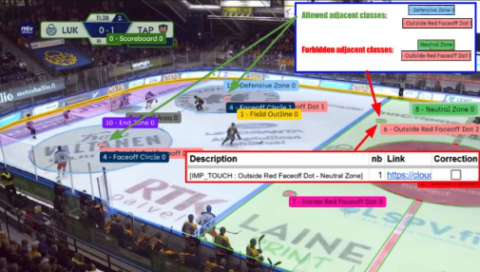
Enfin, nous illustrerons cette approche à travers des exemples concrets montrant comment les validations automatisées permettent de détecter des erreurs difficiles à identifier manuellement, de produire des rapports de correction ciblés et d’aider les équipes qualité à concentrer leurs efforts là où l’expertise humaine apporte le plus de valeur.
De la revue qualité manuelle aux contrôles automatisés
Le contrôle qualité est un élément essentiel de tout projet d’annotation. Afin de maintenir un niveau de qualité élevé tout au long de nos projets, nous avons mis en place une approche multi-niveaux combinant suivi qualité en temps réel, revues par échantillonnage et contrôles automatisés.
Suivi qualité en temps réel
Pendant la phase d’annotation, nos équipes examinent régulièrement les annotations récemment produites et fournissent un retour direct aux annotateurs.
L’objectif est d’identifier au plus tôt les éventuels écarts par rapport aux standards attendus et d’éviter qu’une même erreur ne se propage à un volume plus important de données.
Par exemple, lors d’un projet d’annotation en dermatologie, notre équipe qualité a constaté qu’un annotateur avait commencé à produire des masques de lésions significativement plus petits que prévu. Cette dérive a été rapidement détectée grâce au suivi régulier, ce qui a permis de corriger l’approche avant qu’elle n’impacte un lot plus important de données.
Ce type de revue est essentiel car il favorise l’amélioration continue et l’alignement avec les consignes du projet.
Revue qualité par échantillonnage
En complément du suivi en temps réel, les équipes qualité réalisent généralement des revues sur un échantillon représentatif des annotations produites.
Par exemple, un pourcentage défini de la production peut être revu afin de vérifier que les standards de qualité sont maintenus de manière cohérente.
Cette approche permet de trouver un équilibre entre assurance qualité et efficacité opérationnelle. Une revue manuelle de 100 % des annotations n’est envisageable que lorsqu’elle est explicitement prévue et validée avec le client, car elle mobilise des ressources significativement plus importantes.
Quand l’automatisation apporte de la valeur
Certains contrôles automatisés sont répétitifs, objectifs et reposent sur des règles clairement définies. Dans ces cas, la revue manuelle n’apporte pas nécessairement de valeur supplémentaire.
L’automatisation de ces validations permet aux équipes qualité de concentrer leur temps et leur expertise sur les cas nécessitant un jugement humain, tout en garantissant l’application systématique des contrôles sur l’ensemble du dataset.
Parmi les exemples les plus courants :
- les contrôles de taille et de surface,
- les contrôles de relations spatiales entre objets,
- la vérification de la présence attendue des objets,
- la détection d’artefacts d’annotation ou de bruit.
Les contrôles automatisés viennent ainsi compléter les processus qualité existants en ajoutant une couche supplémentaire de validation après la phase d’annotation.
Deux approches complémentaires pour automatiser les contrôles qualité
Les contrôles automatisés peuvent être mis en œuvre de différentes manières selon le type de problème à détecter.
D’après notre expérience, deux approches sont particulièrement efficaces et complémentaires.
Contrôles statistiques
Les contrôles statistiques visent à identifier les annotations qui se comportent différemment du reste du dataset.
Plutôt que de s’appuyer sur des règles prédéfinies, ils recherchent des comportements atypiques, des valeurs aberrantes ou des incohérences au sein d’un ensemble d’annotations. Ces analyses peuvent être réalisées à l’échelle de l’image, de l’objet ou même de l’annotateur.
Par exemple :
- des masques significativement plus petits ou plus grands que ceux observés dans le reste du dataset,
- des objets positionnés différemment d’annotations similaires.
Les contrôles statistiques sont particulièrement utiles car ils permettent d’identifier des problèmes qui n’avaient pas été anticipés lors de la rédaction des consignes d’annotation.
Par exemple, l’analyse de la distribution des tailles d’objets peut révéler un petit nombre d’annotations très différentes du reste du dataset. Même si ces cas ne sont pas nécessairement incorrects, ils méritent souvent une vérification plus approfondie et permettent de mettre en évidence des incohérences, des cas limites ou des incompréhensions des consignes.
Contrôles basés sur des règles
Les contrôles basés sur des règles vérifient que les annotations respectent les consignes explicites du projet.
Ces consignes sont généralement définies par le client et décrites dans les guides d’annotation.
Par exemple :
- vérifier qu’un objet est contenu dans un autre,
- s’assurer que deux régions ne se chevauchent pas ou ne sont pas en contact,
- vérifier que certaines relations attendues entre objets sont respectées,
- détecter des artefacts de segmentation ou des éléments qui ne doivent pas être présents dans le dataset final.
Parce qu’ils reposent sur des règles objectives et reproductibles, ces contrôles peuvent être appliqués systématiquement sur de grands volumes de données et générer des tâches de correction ciblées pour les équipes qualité.
Cependant, toutes les règles de validation ne méritent pas nécessairement d’être automatisées. Concevoir un contrôle automatisé implique de trouver le bon équilibre entre effort de développement, fiabilité et impact attendu.
L’un des défis consiste à déterminer où commencer et où s’arrêter : un contrôle complexe peut nécessiter un effort important de développement et de maintenance tout en ne détectant qu’un faible nombre de problèmes. À l’inverse, une règle plus simple, appliquée de manière systématique à l’ensemble du dataset, peut générer beaucoup plus de valeur en réduisant le temps de revue et en évitant les erreurs récurrentes.
Dans la pratique, les contrôles les plus utiles ne sont pas nécessairement les plus sophistiqués, mais ceux qui réduisent significativement le temps de revue tout en améliorant la qualité globale du dataset.
Combiner les deux approches
Bien que les contrôles statistiques et les contrôles basés sur des règles soient conceptuellement différents, ils sont souvent complémentaires dans la pratique.
Une analyse statistique peut mettre en évidence des annotations atypiques qui se révèlent finalement être des violations des consignes du projet. À l’inverse, un contrôle basé sur des règles peut fournir une explication précise à une anomalie initialement identifiée par une méthode statistique.
L’objectif n’est pas de déterminer automatiquement si une annotation est correcte dans tous les cas. Ces contrôles permettent plutôt d’identifier des cas suspects, de générer des rapports de revue exploitables et de produire des indicateurs qualité favorisant l’amélioration continue du processus d’annotation.
En combinant analyses statistiques, règles de validation spécifiques au projet et expertise humaine, les équipes qualité peuvent concentrer leurs efforts là où ils créent le plus de valeur tout en maintenant des standards de qualité cohérents à l’échelle du dataset.
Découvrez l'article complet sur le site de PeopleforAi ici